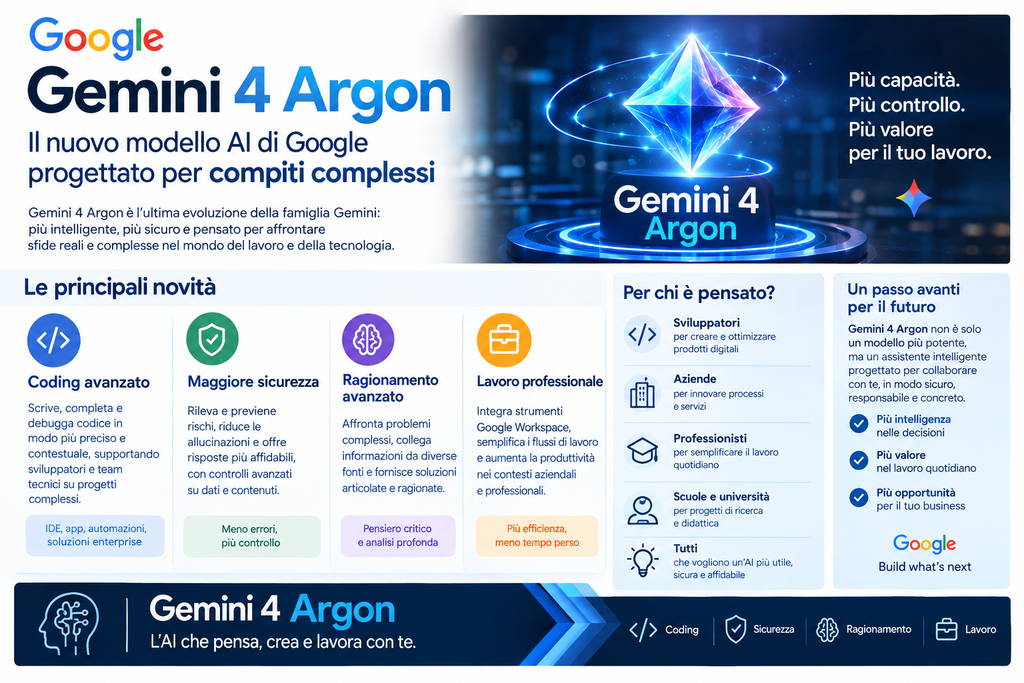
Google ha annunciato Gemini 4 Argon, un nuovo modello di intelligenza artificiale pensato per affrontare attività complesse e di lunga durata. L’obiettivo dichiarato è offrire prestazioni avanzate nello sviluppo software, nella cybersecurity e nel lavoro professionale in ambiti come finanza, diritto e analisi documentale.
Non si tratta, almeno per ora, di un prodotto destinato subito al grande pubblico. Google ha scelto un rilascio graduale, mettendo inizialmente Gemini 4 Argon a disposizione di un gruppo selezionato di esperti di sicurezza informatica attraverso il programma Fairwind.
Un modello progettato per compiti complessi
Con Gemini 4 Argon, Google vuole rafforzare la propria posizione nella competizione globale sull’intelligenza artificiale generativa. Il modello viene presentato come una soluzione in grado di sostenere ragionamenti approfonditi e flussi di lavoro complessi, anche quando una richiesta richiede molti passaggi, grandi quantità di documenti o un elevato livello di precisione.
In pratica, Gemini 4 Argon non nasce soltanto per rispondere a una domanda, riassumere un testo o generare una semplice email. L’ambizione è quella di supportare attività che assomigliano sempre di più a veri progetti professionali: analizzare codice, individuare vulnerabilità, confrontare documenti, elaborare informazioni finanziarie o contribuire alla gestione di procedure aziendali articolate.
Questo aspetto è interessante soprattutto per aziende, software house, studi professionali, consulenti e team digitali; quando l’AI riesce a mantenere il contesto di una lavorazione lunga, può diventare un alleato concreto non solo nella fase creativa, ma anche in quella operativa, tecnica e decisionale.
Il limite di un milione di token
Tra gli elementi più rilevanti dell’annuncio c’è l’aumento del limite di output: Gemini 4 Argon può generare fino a un milione di token, rispetto ai 64.000 token indicati per le generazioni precedenti. Google presenta questo salto come una leva per affrontare ragionamenti più lunghi, risposte più articolate e attività che richiedono la produzione o l’analisi di grandi quantità di contenuti. Un limite più ampio può rendere più semplice lavorare su documentazione complessa, basi di codice estese, report aziendali, raccolte di contratti, ricerche di mercato o progetti editoriali strutturati.
Immaginiamo, ad esempio, un’agenzia che deve analizzare decine di documenti relativi a un cliente: materiali commerciali, pagine web, presentazioni, campagne precedenti, dati SEO e indicazioni di brand. Un modello capace di gestire un contesto molto più esteso potrebbe aiutare a collegare le informazioni, trovare incoerenze e proporre una strategia in modo più completo.
Naturalmente, una maggiore capacità non elimina la necessità di controllo umano. Anche un sistema avanzato può commettere errori, interpretare male un’informazione o produrre contenuti credibili ma non corretti. Per questo, Gemini 4 Argon va visto come uno strumento di supporto e non come un sostituto automatico delle competenze professionali.
Coding e sviluppo software
Uno dei campi in cui Google vuole posizionare Gemini 4 Argon è il software engineering! Secondo l’azienda, il modello è progettato per lavorare su attività reali di sviluppo, comprese l’analisi di progetti complessi, il supporto alle migrazioni di codice e la risoluzione di problemi tecnici.
Per sviluppatori, web agency e professionisti che realizzano siti o applicazioni, la prospettiva è significativa. Un modello AI più evoluto potrebbe accelerare la scrittura di funzioni, suggerire correzioni, leggere codice esistente e aiutare a documentare progetti spesso difficili da mantenere nel tempo.
La differenza, però, non dovrebbe essere cercata solo nella velocità. Scrivere codice più in fretta è utile, ma il vero valore emerge quando l’AI riesce a comprendere il contesto: gli obiettivi del progetto, le dipendenze tecniche, gli standard di sicurezza, il comportamento atteso dagli utenti e i limiti dell’infrastruttura.
Google ha inoltre dichiarato che Gemini 4 Argon è già impiegato nei propri flussi di lavoro interni, anche per attività come le migrazioni su codebase di grandi dimensioni. È un segnale importante perché indica che il modello non è pensato soltanto per demo spettacolari, ma per processi operativi che richiedono continuità, affidabilità e capacità di lavorare su sistemi articolati.
Cybersecurity al centro
La sicurezza informatica è probabilmente l’area più delicata e strategica del lancio, perchè Google ha deciso di distribuire Gemini 4 Argon dapprima a cyber defender fidati, dato che il modello può avere applicazioni molto potenti nell’individuazione, nella verifica e nella correzione di vulnerabilità software.
Secondo quanto comunicato, Argon può contribuire a identificare falle critiche, validarle e suggerire o applicare interventi correttivi; si tratta di capacità che possono aiutare le organizzazioni a ridurre i tempi di risposta agli incidenti e a migliorare la prevenzione, soprattutto in contesti in cui le superfici di attacco aumentano ogni giorno.
Allo stesso tempo, strumenti di questo tipo richiedono una gestione molto prudente. Le stesse competenze che consentono di trovare una vulnerabilità possono essere sfruttate in modo improprio da soggetti malevoli. È proprio per questo che Google sta adottando un approccio controllato, con accesso riservato e valutazioni progressive prima di una disponibilità più ampia.
L’azienda afferma inoltre di voler rafforzare le protezioni contro abusi, prompt injection e comportamenti non allineati agli obiettivi di sicurezza. È un punto fondamentale: con modelli sempre più capaci, la qualità tecnica non basta. Servono anche regole, controlli, monitoraggio e responsabilità nell’utilizzo.
Applicazioni per aziende e professionisti
Gemini 4 Argon guarda anche al cosiddetto enterprise knowledge work, cioè a tutte quelle attività professionali basate su documenti, informazioni, ricerche, procedure e decisioni. Google cita in particolare gli ambiti legale e finanziario, ma il potenziale coinvolge molti altri settori.
Per un consulente, un’azienda o un professionista del marketing, un sistema di questo livello potrebbe essere utile per preparare bozze di offerte, esaminare brief complessi, ordinare dati, confrontare report, costruire piani editoriali, elaborare analisi competitive e trasformare informazioni sparse in materiali più chiari.
Anche la produzione di contenuti potrebbe evolvere. Non nel senso di generare articoli in automatico senza supervisione, ma nel rendere più rapida la fase di ricerca, organizzazione e revisione. Un autore potrebbe usare l’AI per trovare una struttura, identificare le domande più frequenti dei lettori, proporre angoli editoriali o verificare che un testo risponda davvero all’intento di ricerca.
Il vantaggio concreto sarà quindi legato alla capacità di integrare l’intelligenza artificiale nei processi quotidiani. Chi utilizza questi strumenti con metodo, competenze e spirito critico potrà ridurre le attività ripetitive e dedicare più tempo alla strategia, alla relazione con i clienti e alla qualità finale del lavoro.
Disponibilità e prezzo
Al momento, Gemini 4 Argon non è disponibile in modo generalizzato per utenti privati e sviluppatori, dato che Google ha avviato il rollout attraverso il Fairwind Program, coinvolgendo un gruppo selezionato di organizzazioni attive nella difesa informatica, mentre l’accesso più ampio dovrebbe arrivare in fasi successive.
L’azienda ha indicato che la disponibilità futura riguarderà sviluppatori, imprese e utenti, con priorità prevista per i clienti API a pagamento e per gli abbonati Google AI Ultra. Tuttavia, non è stata comunicata una data precisa per l’apertura al grande pubblico.
Sul fronte dei costi, però, Google ha annunciato un prezzo introduttivo di 2 dollari per un milione di token in input e 10 dollari per un milione di token in output. Per gli input memorizzati nella cache è previsto uno sconto del 95% rispetto al prezzo standard di input.
Questa politica di prezzo mostra quanto il mercato dell’AI stia diventando competitivo. Per le imprese non conta soltanto la qualità del modello: incidono anche costi di utilizzo, facilità di integrazione, velocità delle risposte, sicurezza dei dati e compatibilità con gli strumenti già adottati.
Cosa aspettarsi nei prossimi mesi
L’annuncio di Gemini 4 Argon conferma una tendenza ormai evidente: i modelli AI stanno passando dalla semplice generazione di testi e immagini a strumenti pensati per gestire attività professionali sempre più complesse. Google punta in particolare su ragionamento prolungato, programmazione, analisi documentale e difesa informatica.
Per ora è prematuro capire quanto queste promesse si tradurranno in risultati concreti nell’uso quotidiano. I benchmark e le dichiarazioni delle aziende sono utili, ma la vera prova arriverà quando sviluppatori, imprese e professionisti potranno sperimentare il modello su progetti reali, con vincoli di tempi, budget e affidabilità.
Una cosa, però, è chiara: Gemini 4 Argon non rappresenta solo un nuovo nome nella famiglia Gemini. È il tentativo di Google di costruire un’AI più utile nei processi di lavoro reali, dove non basta dare una risposta veloce, ma serve comprendere il contesto, mantenere la coerenza e operare con responsabilità.
Articolo aggiornato al 1° Giugno 2026 | Fonte: Il Sole 24 Ore / Infodata | Rielaborazione editoriale a cura di Enjoy System -| Tutti i dati tecnici sono tratti dalla documentazione ufficiale Anthropic.
Anthropic ha rilasciato Claude Opus 4.8, il più recente aggiornamento della sua famiglia di modelli linguistici avanzati, segnando un punto di svolta nella qualità del ragionamento e nell’affidabilità delle risposte. Questo modello non si distingue per essere semplicemente “più veloce” o “più grande”: l’innovazione di Opus 4.8 risiede in una combinazione inedita di onestà strutturale, capacità agentiche estese e controllo granulare dello sforzo cognitivo.
Cos’è Claude Opus 4.8?
Un Modello Pensato per il Lavoro Reale: Claude Opus 4.8 è stato progettato esplicitamente per attività professionali complesse: coding su larga scala, gestione di agenti software autonomi e analisi di documenti articolati. A differenza dei modelli precedenti, orientati principalmente alla conversazione, Opus 4.8 eccelle nei cosiddetti task “long-horizon” — quei compiti che richiedono pianificazione multi-step, memoria contestuale estesa e coerenza logica lungo sessioni di lavoro prolungate.
Un esempio concreto: uno sviluppatore che deve effettuare la migrazione di una codebase da Python 2 a Python 3 su migliaia di file può ora delegare l’intera operazione a Opus 4.8 tramite Claude Code, il quale genera autonomamente uno script di orchestrazione e distribuisce il lavoro su più subagenti in parallelo — riducendo ore di intervento manuale a una singola istruzione.
Dynamic Workflows e Subagenti in Parallelo
Una delle novità più rilevanti per chi utilizza l’AI in contesti aziendali è l’introduzione dei dynamic workflows in Claude Code, attualmente in fase di anteprima di ricerca. Questo sistema consente al modello di suddividere automaticamente un compito complesso in sotto-attività discrete, assegnarle a subagenti specializzati che lavorano in parallelo, e quindi aggregare e verificare i risultati prima di restituire l’output finale all’utente.
Immaginate un team marketing che deve analizzare 500 report di performance campagna, estrarre insight chiave e produrre un documento strategico: con i dynamic workflows, Opus 4.8 può parallelizzare l’analisi dei report su più agenti e consegnare una sintesi coerente in una frazione del tempo tradizionale. Questa architettura avvicina concretamente l’AI al funzionamento di un team di lavoro distribuito, piuttosto che di un singolo assistente.
Il Controllo dello Sforzo: da “Low” a “Max”
Una delle funzionalità più interessanti per gli utenti avanzati è la possibilità di regolare il livello di effort del modello. In Claude.ai e Cowork è ora possibile scegliere tra cinque livelli di elaborazione:
– LOW/MEDIUM: per risposte rapide a domande semplici, con minor consumo di token
– HIGH — impostazione predefinita, bilanciamento tra velocità e profondità
– EXTRA/MAX: per compiti ad alta complessità, come debugging avanzato o analisi legali di contratti complessi
Questa granularità permette ai team di ottimizzare i costi in modo intelligente: un’azienda SaaS potrebbe impostare “Low” per le FAQ del customer support e “Max” per l’analisi dei bug critici in produzione, gestendo così il budget API in modo strategico. Il prezzo standard resta invariato rispetto a Opus 4.7 — 5$/milione di token in input e 25$/milione in output — mentre la modalità Fast, fino a 2,5 volte più rapida, è disponibile a 10$/milione in input e 50$/milione in output.
Sempre più onesto e allineato
Il tema su cui Anthropic insiste maggiormente è quello dell’allineamento e dell’onestà. Opus 4.8 è stato significativamente migliorato nella sua tendenza ad ammettere incertezze e limiti informativi, riducendo la produzione di risposte inventate o formulate con falsa certezza — il fenomeno noto come hallucination.
Un caso pratico emblematico: se interrogato su una normativa fiscale aggiornata per la quale non dispone di dati certi, Opus 4.8 tenderà a segnalare esplicitamente il proprio limite di conoscenza e a suggerire fonti verificabili, piuttosto che fornire una risposta plausibile ma potenzialmente errata. Secondo i test interni di Anthropic, il modello riduce fino a quattro volte la probabilità di ignorare errori nel codice rispetto alle versioni precedenti. Questo rappresenta un cambio di paradigma: l’AI non è più valutata solo per ciò che sa fare, ma anche per come gestisce ciò che non sa fare.
Benchmark, Pricing e Disponibilità
Opus 4.8 è disponibile da subito su tutte le piattaforme Anthropic, accessibile via API con il riferimento claude-opus-4-8. Dal punto di vista benchmark, il modello mostra progressi netti in coding, tool use, contesto lungo e task agentici, mentre non raggiunge ancora le prestazioni attese dalla classe di modelli Mythos — la prossima generazione annunciata da Anthropic per le settimane successive.
Modalità
Input ($/M token)
Output ($/M token)
Velocità
Standard
$5
$25
Baseline
Fast
$10
$50
Fino a 2,5x più rapido
Cosa Aspettarsi Dopo? la Classe Mythos!
Anthropic ha confermato che i modelli di classe Mythos sono in arrivo nelle prossime settimane, ma solo dopo il completamento del rafforzamento delle salvaguardie cyber. Si tratta di un segnale importante: l’azienda sta esplicitamente rallentando il rilascio di modelli più potenti per garantire che i meccanismi di sicurezza siano adeguati prima del deployment. Una strategia che, in un settore dove la corsa alla performance domina, risulta significativamente controcorrente — e che consolida il posizionamento di Anthropic come attore orientato alla AI sicura e responsabile. Contattaci per avere ulteriori informazioni o per partecipare ai nuovi corsi da remoto sull’intelligenza artificiale
[contact-form-7 id=”57153ad” title=”Modulo per articolo”]
Il nuovo modello Qwen 3.6-Plus di Alibaba Group Holding Limited ha registrato risultati eccezionali nel Code Arena Benchmark pubblicato da LMArena il 3 aprile 2026. Con un punteggio di 1454, Qwen 3.6-Plus si è posizionato ottavo a livello globale e secondo nella classifica React, che misura la capacità dei modelli di gestire flussi di lavoro agentici, ovvero processi di sviluppo autonomi basati su più passaggi di ragionamento e interazioni con strumenti esterni.
LMArena è diventato negli ultimi mesi uno dei riferimenti più autorevoli nel campo dei benchmark multimodali e di codice, grazie alla combinazione di metriche tecniche e valutazioni pratiche in ambienti simulati di sviluppo software. Il successo di Alibaba in questo contesto segna un punto di svolta strategico per la ricerca AI cinese, che finora aveva faticato a competere stabilmente con le big tech americane nei test dedicati al reasoning complesso e alla programmazione intelligente.
Prestazioni solide nel coding agentico
Il risultato di Qwen 3.6-Plus è stato confermato ufficialmente dal team LMArena in un post su X, sottolineando come il modello abbia raggiunto prestazioni paragonabili alle principali soluzioni proprietarie di Anthropic e Google.
“Qwen 3.6 Plus Preview è il #2 lab nel React leaderboard del Code Arena, che valuta modelli basati su workflow agentici”, ha scritto il team di LMArena, riferendosi alle capacità avanzate del modello nel gestire sessioni di programmazione simulate.
A differenza di altri benchmark focalizzati sulla generazione di codice singolo o sulla risoluzione di esercizi accademici, Code Arena riproduce un contesto pratico: qui i modelli devono pianificare, scrivere, testare e ottimizzare interi progetti software, seguendo un ciclo di sviluppo simile a quello umano. Questo rende il test un indicatore reale della produttività e dell’autonomia operativa dei modelli di intelligenza artificiale, una frontiera su cui si concentra oggi la ricerca AI di terza generazione.
L’espansione di Qwen nel coding
Il successo di Qwen 3.6-Plus si inserisce in una strategia di lungo periodo. Già nel 2025 Alibaba aveva presentato il modello Qwen 3.5, un sistema mixture-of-experts (MoE) da ben 397 miliardi di parametri, che aveva conquistato la fascia alta del ranking con un punteggio di 1386. Accanto ad esso, il modello Qwen3-Coder, progettato specificamente per lo sviluppo software e la risoluzione di problemi complessi, aveva già superato il 70% nel benchmark SWE-Bench Verified, una delle prove più impegnative per modelli di coding e debugging automatico.
Con la versione Qwen 3.6-Plus, Alibaba introduce una architettura ibrida, dove l’attenzione lineare si fonde con la logica sparse routing tipica dei modelli MoE. Il risultato è una gestione dei token molto più efficiente — fino a 1 milione di token per singola sessione — e una coerenza semantica superiore anche in processi di reasoning prolungato. Inoltre, il sistema integra nativamente la chain-of-thought reasoning, una tecnologia che consente al modello di conservare tracce di ragionamento lungo sequenze complesse, migliorando la capacità di debug e il design iterativo del codice.
Un panorama competitivo sempre più serrato
Nel contesto internazionale, la famiglia di modelli Claude di Anthropic domina ancora la vetta del ranking globale di Code Arena, occupando le prime cinque posizioni con le versioni Opus e Sonnet 4.6. Subito dopo si trovano i modelli Gemini 3.1 Pro Preview di Google e GPT-5.4-High di OpenAI, seguiti da Qwen 3.6-Plus. Questo piazzamento evidenzia non solo la qualità del modello di Alibaba, ma anche il livello di maturità raggiunto dal panorama AI asiatico, ormai pienamente competitivo a livello internazionale.
Tra i modelli open-source e open-weight, la serie Qwen continua a distinguersi con Qwen 3.5-397B e Qwen 3.5-122B, stabilmente rispettivamente alla 26ª e 32ª posizione. Un portavoce di Alibaba ha commentato il risultato affermando che:
“Questo traguardo dimostra il nostro impegno costante verso l’innovazione AI e la volontà di fornire strumenti potenti, accessibili e realmente utili per gli sviluppatori di tutto il mondo.”
L’affermazione conferma la strategia di Alibaba volta a posizionarsi come fornitore globale di infrastrutture AI, abbandonando la logica esclusiva del mercato cinese per entrare nei circuiti di benchmark e valutazione internazionali.
Impatto globale e prospettive future
Il successo del sistema Qwen non rappresenta solo un traguardo tecnico, ma un segnale geopolitico della maturità raggiunta dall’intelligenza artificiale cinese. Negli ultimi 18 mesi, Alibaba ha lanciato un ecosistema di modelli che copre linguistica, multimodalità e sviluppo software, creando un’architettura scalabile e modulare pronta per piattaforme cloud aziendali e servizi generativi personalizzati. Con le prove di benchmark a supporto, Qwen si avvia a diventare una delle principali alternative open-weight di classe enterprise, capace di competere con colossi americani anche nei settori strategici del coding, del design AI e dell’automazione digitale.
L’insieme di queste performance suggerisce un futuro dove la competizione non sarà più definita dall’origine geografica del modello, ma dalla qualità del reasoning agentico e dalla capacità di integrarsi nelle pipeline di sviluppo umano. Con i progressi mostrati nel primo trimestre 2026, Qwen 3.6-Plus potrebbe inaugurare una nuova generazione di sistemi AI autonomi per il coding e l’ingegneria software avanzata.